行业动态简介
在当今数字化、智能化时代,数据分析和机器学习技术得到了前所未有的发展。特别是在自然语言处理(NLP)领域中,一个全新的概念正引领着创新潮流——大模型微调训练。这个过程涉及到大规模预训练模型的优化与定制化配置,在保持模型初始性能的前提下进行针对性修改或扩展,以提高其在特定任务上的表现。
深度解析:大模型为何炙手可热?
大模型微调训练之所以备受关注,是因为它大大提升了我们面对复杂场景时处理数据的能力。想象一下,一个具备通用能力的强大模型就像是一个多功能的工具箱——而通过微调训练,则能够针对具体的任务需求更换合适的工具。
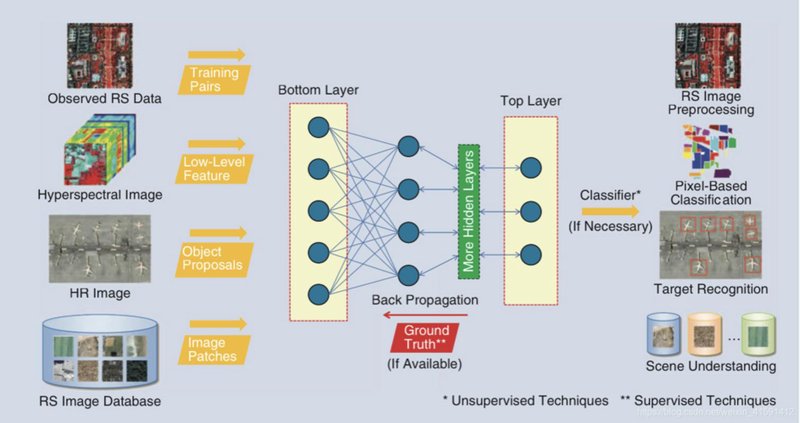
优势对比:传统模型 vs 微调后的模型
与传统的单一任务训练模型相比,经过微调的大模型在以下方面展现出了显著的优势:
- 泛化能力更强:得益于其庞大的预训练参数量,大模型往往能够在多种场景中表现出更高的鲁棒性和适应性。
- 减少标注样本需求:对于大规模的标注数据集而言,在小部分样本文本上进行微调可以有效降低对详细注释的需求,并且在保持较高准确度的同时大大缩减了投入成本。
- 易于构建多样化的应用场景:比如情感分析、内容生成等多个NLP子领域的任务,通过合适的策略进行调整即可快速部署至实际业务环境中。
实际案例解析
最近的一项研究表明,在电商推荐系统中应用此方法能够显著提高用户的购买转化率。通过对包含用户历史记录的大规模文本语料库进行预训练,并在此基础上针对特定类型商品推荐做微调后,模型表现出了比标准方案更为精准的个性化建议。
趋势展望
随着计算资源成本降低与云计算技术的发展,大模型微调训练正逐渐成为行业内的热门研究方向。未来几年内,这一领域的探索将不断深入,为企业带来更加多姿多彩的产品和服务可能性。
总结起来,“大模型微调训练”这一概念不仅体现了当前科技的进步趋势——即通过大规模数据的迭代优化来提升模型性能;同时也代表了一个可以极大激发创造力和推动实际应用发展的重要工具。让我们共同期待,这个充满潜力的世界将如何因我们的努力而更加精彩!