在人工智能技术迅猛发展的今天,从语音识别到自动驾驶的各个领域都在享受着这一科技变革带来的红利。而在众多应用中,最为核心的一环便是大模型微调训练。
首先来了解一下什么是大模型微调训练。简单来说,就是将通用的大规模预训练模型进行特定任务的专业化调整和优化,从而在保持原有模型优秀特性的基础上,进一步提升模型的性能和精准度。就好比厨师手中的食材,通过不同的烹饪方法,可以激发出原料最合适的味道。
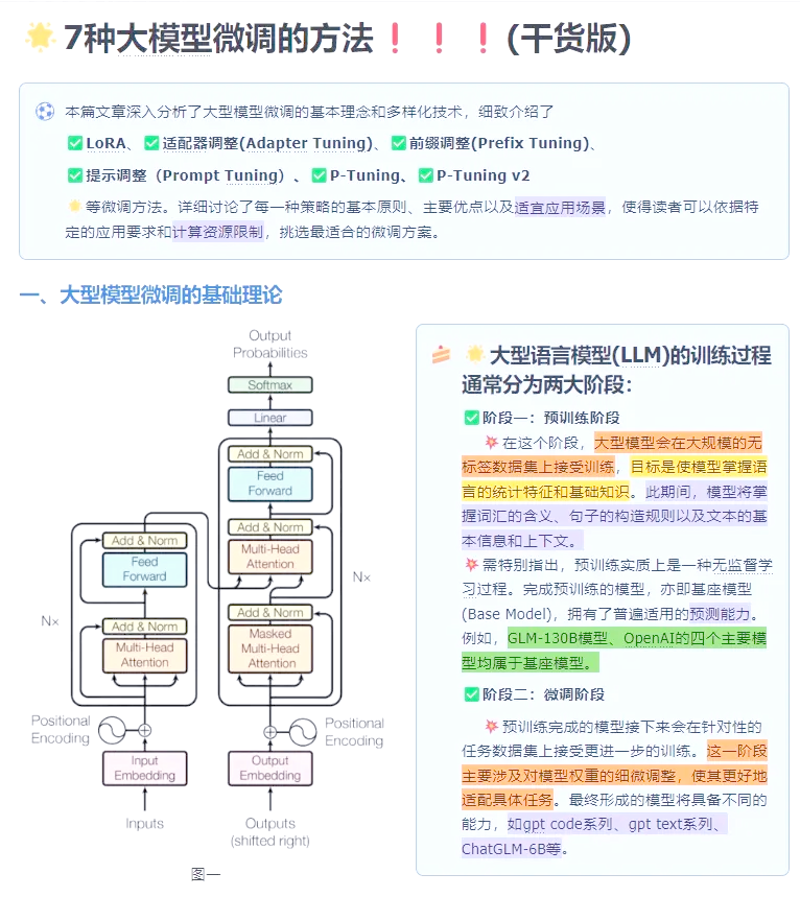
以自然语言处理为例,在大规模语料库上经过深度学习训练的大模型,已经具备了强大的表达能力与理解能力。但若将其直接应用于特定场景(如客户服务对话),难免会出现生硬或不适的情况。这时,我们就需要通过微调训练来让这个大模型更接近我们实际业务的需求。
那么如何进行有效的微调训练呢?首先是选择合适的数据集。数据作为机器学习的基石,质量直接影响到了最终效果;其次是算法优化,包括但不限于正则化、梯度下降等技术的应用,在保证模型泛化能力的同时提升学习效率。
值得注意的是,并非所有场景都适合大规模通用模型直接微调。比如医疗健康领域中涉及大量隐私保护要求的信息处理时,就需要充分考虑法律法规的约束性;再如金融决策这类需要高度精准判断的情况,则往往更加注重于稳定性而非速度。
总结来说,大模型微调训练如同一把双刃剑,其既能为各行各业提供强大的技术支持,也将带来伦理和法律上的挑战。企业需在享受科技带来的便利之余,保持对于行业规则及道德底线的敬畏之心,在推动技术进步的同时促进社会和谐发展。