随着科技的不断进步,大模型微调训练已经成为人工智能领域的一颗新星。它不仅仅代表着技术层面的革新,更是应用策略上的重大转变。
大模型的核心在于其强大的底层架构支撑。这些模型在大量数据上进行预训练后,具备了很强的基础语言理解与生成能力。然而,这类模型往往存在对特定应用场景适应性不足的问题。这时,微调训练就显得尤为关键。
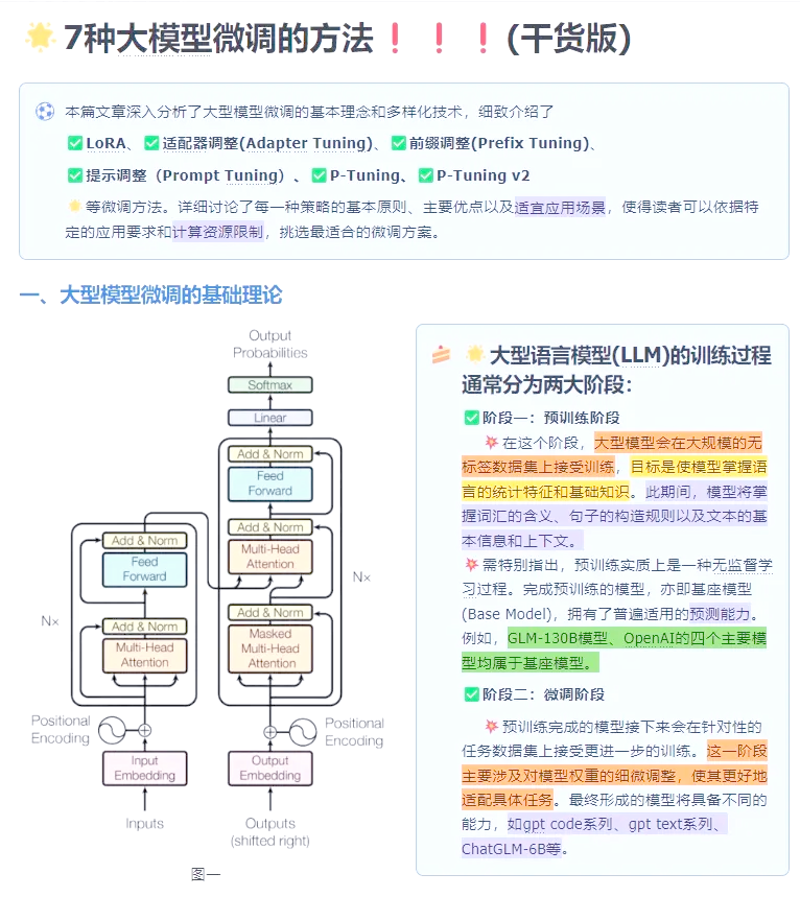
通过对比传统的人工智能项目流程,我们可以发现,大模型微调训练的引入带来了显著的变化。传统的项目往往是先搭建小规模模型,并逐层进行人工优化和调整;而大模型微调则是在大规模预训练的基础上,快速适配新的任务需求,大大减少了开发时间成本。
以自然语言处理为例,在社交媒体实时舆情分析中,我们可以通过对大规模语料库的初步训练,建立起一个通用的语言理解能力。然后进行针对性数据的微调训练,以便更加准确捕捉不同平台上的特定情绪和话题趋势。这种灵活性使得大模型在实战中的表现更为出色。
不仅如此,微调训练还能够显著提升模型的泛化能力和鲁棒性。通过有选择地调整预训练模型的部分参数和权重,使其更好地服务于具体任务。这不仅为复杂的应用场景提供了更精准的解决方案,同时也避免了从零开始重新训练带来的工作量增加问题。
综上所述,大模型微调训练正逐渐成为人工智能领域不可忽视的力量。它结合了技术与应用的双重优点,在多行业领域的实际操作中展现出巨大潜力。未来,我们有理由相信,这一方法将为更多企业和研究机构带来前所未有的机遇和发展空间。